1 article
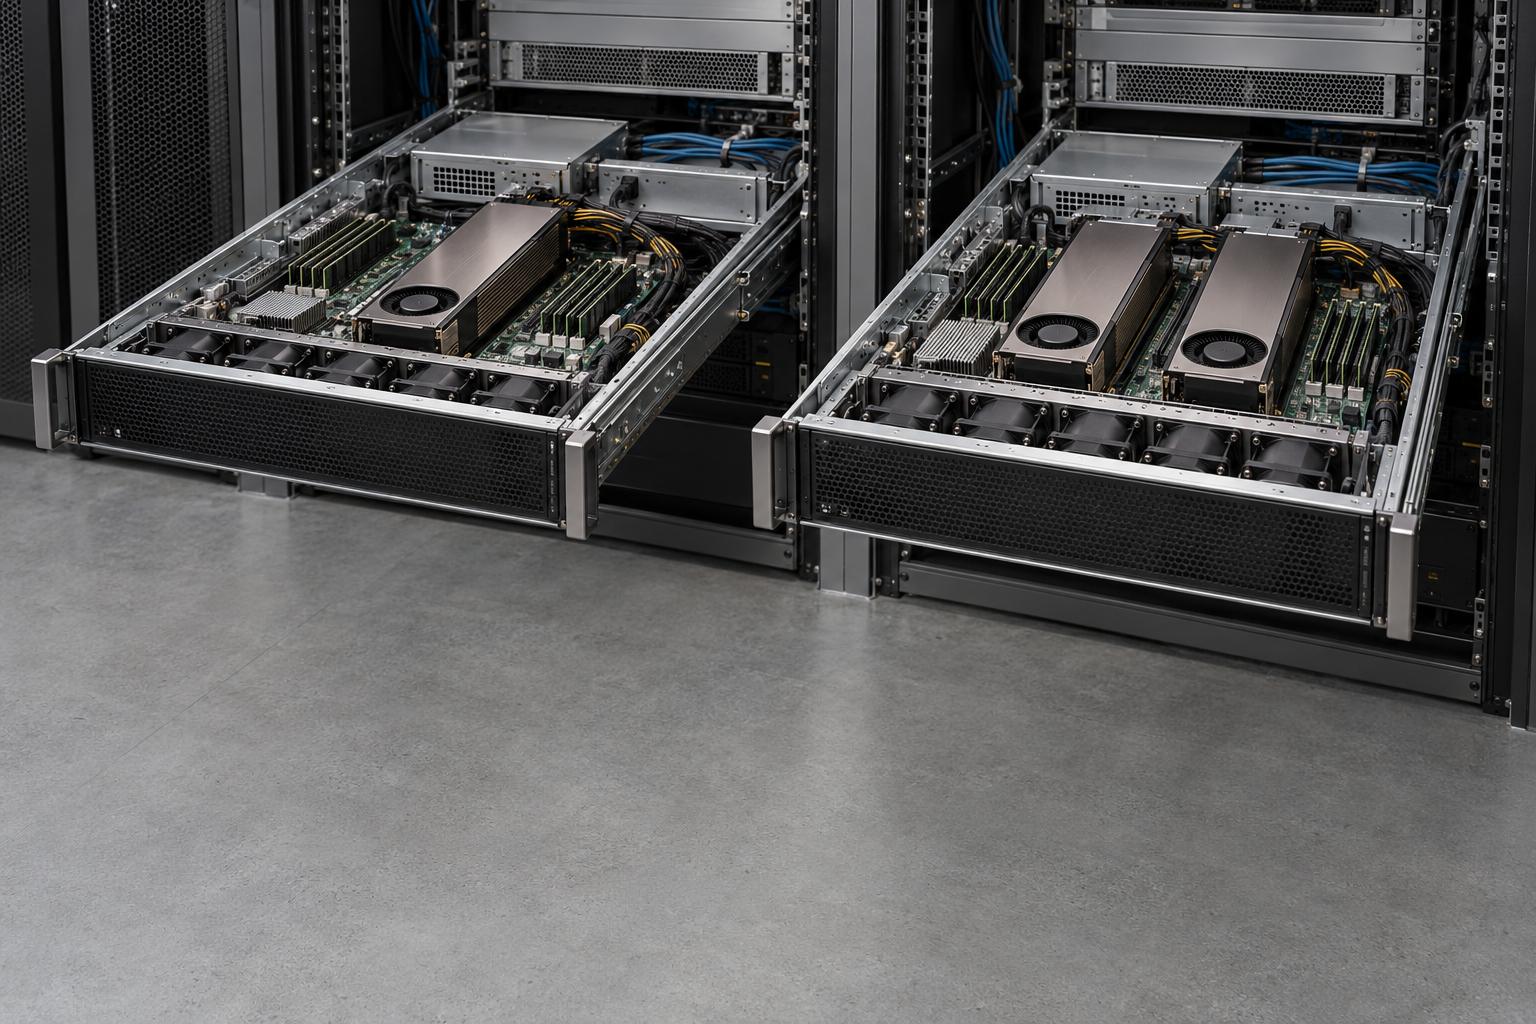
2026 analyst guide to LLM model routing cost: a quality-constrained on-prem fleet model with GPU residency, escalation, break-even near 20 req/s, and RouteLLM, cascade and speculative decoding limits.