1 article
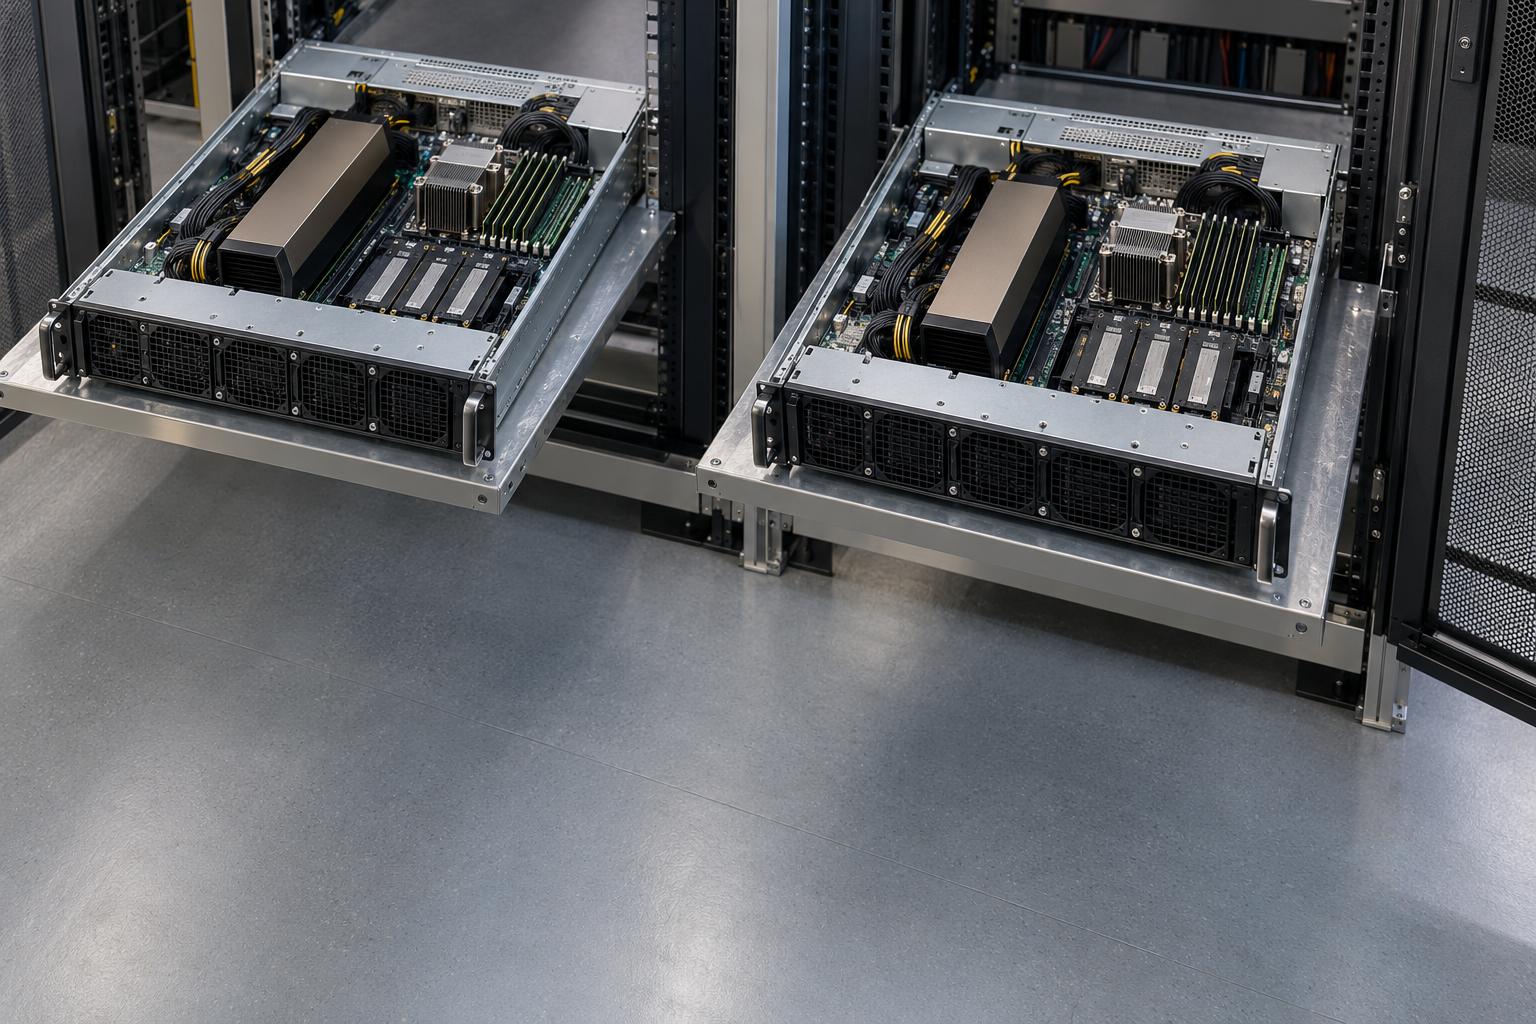
Run TensorRT-LLM on private NVIDIA clusters: version choice, trtllm-serve flags and YAML, precision matrix, KV cache defaults, telemetry, vLLM gate.